RAG
RAG(Retrieval-Augmented Generation)检索增强生成,是一种基于检索和生成的混合模型,用于生成符合用户需求的文本。其核心原理是利用外部知识库或文档集合为大模型提供实时且准确的背景信息,从而弥补大模型的局限性。
RAG模型通常由检索模块和生成模块组成,检索模块用于从数据库中检索与用户查询相关的文本,生成模块用于根据检索到的文本生成符合用户需求的文本。
检索模块
检索模块通常由向量数据库、向量检索器、向量相似度计算器等组成。向量数据库用于存储和管理向量表示,向量检索器用于根据用户查询的向量表示从数据库中检索与之最相关的向量表示,向量相似度计算器用于计算用户查询的向量表示与其他向量表示的相似度。
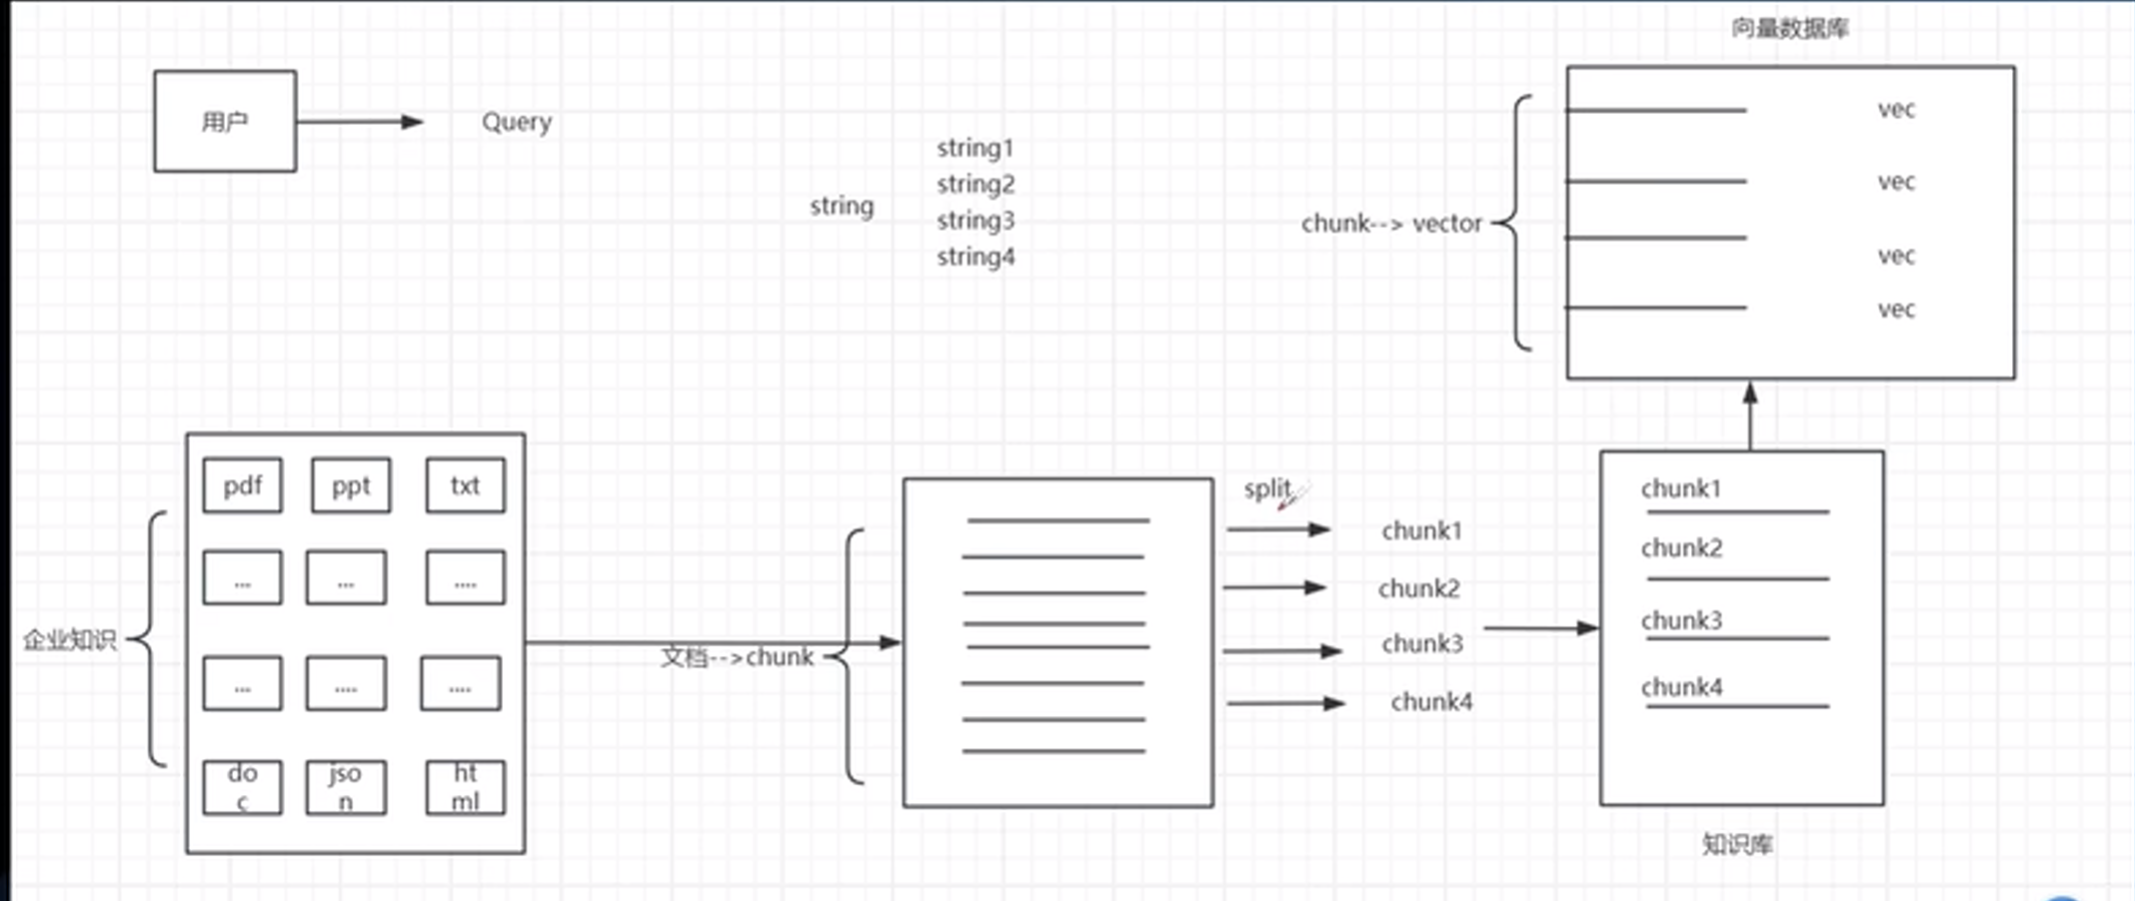
向量数据库构建流程,通常包括以下步骤:
- 数据预处理:将原始文本数据进行分词(一般)、去停用词、词干提取等处理。
- 向量表示构建:使用向量表示模型(如词嵌入、向量化等)对预处理后的文本进行向量化,将文本转换为向量表示,以下给出主流的文档转向量的模型:
| 模型 | 类型 | 向量维度 | 最大Token | MTEB得分 | 价格 (每百万token) | 核心优势 | 适用场景 |
|---|---|---|---|---|---|---|---|
| Qwen3-Embedding-8B | 开源 | 4096 | 32768 | 70.58 | 免费 | 中文最强,多语言SOTA | 中文/多语言知识库,追求极致召回率 |
| OpenAI text-embedding-3-small | 闭源(API) | 1536 | 8192 | 62.3 | $0.02 | 性价比之王,接入简单稳定 | 90%的通用RAG场景,快速验证原型 |
| OpenAI text-embedding-3-large | 闭源(API) | 3072 | 8192 | 64.6 | $0.13 | 精度标杆,企业级可靠 | 对精度要求极高的生产环境 |
| BGE-M3 | 开源 | 1024 | 8192 | 63.0 | 免费 | 开源全能,支持100+语言和混合检索 | 多语言、长文档场景,作为开源baseline |
| Cohere Embed v4 | 闭源(API) | 1536 | 128K | 65.2 | $0.12 | 超长上下文,支持多模态(文本+图片) | 处理整篇论文、合同等超长文档 |
| Jina v5 text | 开源 | - | - | - | 免费 | 轻量部署,资源占用少 | 资源受限或对延迟敏感的场景 |
- 向量数据库构建:将构建好的向量表示存储到向量数据库中,将文本转换为向量表示的映射关系存储到向量数据库中。以下给出主流的向量数据库:
| 数据库 | 类型 | 开源协议 | 部署方式 | 核心优势 | 适合场景 |
|---|---|---|---|---|---|
| Chroma | 独立向量库 | Apache 2.0 | 自托管/嵌入式 | 上手极快,与LangChain/LlamaIndex深度集成 | 原型验证、本地开发,数据量小(<100万) |
| Qdrant | 独立向量库 | Apache 2.0 | 自托管/云服务 | 高性能(Rust编写),资源占用低,支持高级过滤 | 追求性价比的中小型生产项目,对性能和过滤要求高 |
| Milvus | 独立向量库 | Apache 2.0 | 自托管/云服务 | 功能最全,支持十亿级向量,CNCF毕业项目,生态完善 | 大规模(千万级以上)、私有化部署,有较强技术运维团队 |
| Pinecone | 独立向量库 | 闭源 | 全托管SaaS | 零运维,查询延迟稳定,按量付费 | 快速上线、不想管理基础设施的原型或生产项目 |
| pgvector | 融合型(PG扩展) | PostgreSQL协议 | 自托管 | 与PostgreSQL无缝集成,可用SQL操作,架构简单 | 已有PostgreSQL,且向量与关系数据强关联的中小型项目 |
| Weaviate | 独立向量库 | BSD-3 | 自托管/云服务 | 内置混合检索和Rerank模块,开箱即用 | 需要混合检索(语义+关键词)的生产场景 |
- 向量检索器构建:根据用户查询的向量表示,从向量数据库中检索与之最相关的向量表示。
以上我们介绍了检索模块的构建流程,其中值得注意的是:
- 文本转向量,我们通过直接调用了已有的模型进行向量化,但是这个部分也可以当作一个知识点进行扩展学习,达到自己可以实现文本转向量的功能。
- 向量数据库本文只作为一个工具使用,其中如何检索(向量排序,倒排索引)等知识点也需要了解。
代码示例
import os
import hashlib
from typing import List, Dict
import chromadb
from chromadb.config import Settings
from sentence_transformers import SentenceTransformer
import tiktoken


# ============ 1. 文档分块(Chunking)============

def chunk_document(text: str, chunk_size: int = 512, overlap: int = 64) -> List[str]:
    """
    将长文档切分成适合向量化的文本块。
    对于百万字级文档,建议 chunk_size=512,overlap=64。
    """
    # 使用 tiktoken 进行 token 级别的分块
    enc = tiktoken.get_encoding("cl100k_base")
    tokens = enc.encode(text)

    chunks = []
    start = 0
    while start < len(tokens):
        end = start + chunk_size
        chunk_tokens = tokens[start:end]
        chunk_text = enc.decode(chunk_tokens)
        chunks.append(chunk_text)
        start += chunk_size - overlap  # 滑动窗口

    return chunks


# ============ 2. 加载 Embedding 模型 ============

def load_embedding_model(model_name: str = "Qwen/Qwen3-Embedding-8B"):
    """
    加载 Qwen3-Embedding-8B 模型。
    模型维度为 4096[reference:0][reference:1]。
    首次运行会自动从 Hugging Face 下载(约16GB),请确保网络通畅和足够磁盘空间。
    """
    print(f"正在加载模型: {model_name} ...")
    model = SentenceTransformer(model_name)
    # 模型输出维度为 4096
    print(f"模型加载完成,向量维度: {model.get_sentence_embedding_dimension()}")
    return model


# ============ 3. 向量化并存入 Chroma ============

def embed_and_store(
    document_path: str,
    db_path: str = "./chroma_db",
    collection_name: str = "knowledge_base",
    chunk_size: int = 512,
    overlap: int = 64,
    batch_size: int = 100
):
    """
    读取文档 → 分块 → 向量化 → 存入 Chroma(支持断点续传和批量插入)
    """
    # 3.1 读取文档
    print(f"正在读取文档: {document_path}")
    with open(document_path, "r", encoding="utf-8") as f:
        text = f.read()
    print(f"文档总字数: {len(text)} 字符")

    # 3.2 分块
    print(f"正在分块 (chunk_size={chunk_size}, overlap={overlap}) ...")
    chunks = chunk_document(text, chunk_size, overlap)
    print(f"共生成 {len(chunks)} 个文本块")

    # 3.3 加载模型
    model = load_embedding_model()

    # 3.4 初始化 Chroma 持久化客户端[reference:2]
    client = chromadb.PersistentClient(path=db_path)

    # 获取或创建 Collection[reference:4]
    collection = client.get_or_create_collection(
        name=collection_name,
        metadata={"hnsw:space": "cosine"}  # 使用余弦相似度
    )
    print(f"Collection '{collection_name}' 已就绪,当前文档数: {collection.count()}")

    # 3.5 批量向量化并存入
    total = len(chunks)
    for i in range(0, total, batch_size):
        batch_chunks = chunks[i:i + batch_size]

        # 生成唯一 ID(基于文本内容的 MD5,确保可重复运行不重复插入)
        ids = [
            hashlib.md5(chunk.encode("utf-8")).hexdigest()
            for chunk in batch_chunks
        ]

        # 检查哪些 ID 已存在(避免重复插入)
        existing_ids = set()
        for chunk_id in ids:
            try:
                result = collection.get(ids=[chunk_id])
                if result and result.get("ids"):
                    existing_ids.add(chunk_id)
            except:
                pass

        # 过滤掉已存在的块
        new_chunks = []
        new_ids = []
        for chunk, cid in zip(batch_chunks, ids):
            if cid not in existing_ids:
                new_chunks.append(chunk)
                new_ids.append(cid)

        if not new_chunks:
            print(f"批次 {i//batch_size + 1}: 全部已存在,跳过")
            continue

        # 向量化
        print(f"批次 {i//batch_size + 1}: 正在向量化 {len(new_chunks)} 个文本块 ...")
        embeddings = model.encode(
            new_chunks,
            normalize_embeddings=True,  # 归一化,便于余弦相似度计算
            show_progress_bar=True
        ).tolist()

        # 存入 Chroma[reference:7]
        collection.add(
            ids=new_ids,
            documents=new_chunks,
            embeddings=embeddings
        )
        print(f"批次 {i//batch_size + 1}: 成功存入 {len(new_chunks)} 条")

    print(f"全部完成!共存入 {collection.count()} 条向量")


# ============ 4. 查询示例 ============

def query_knowledge(
    query_text: str,
    db_path: str = "./chroma_db",
    collection_name: str = "knowledge_base",
    n_results: int = 5
):
    """
    从 Chroma 中检索最相关的文档块
    """
    # 加载模型
    model = load_embedding_model()

    # 连接数据库
    client = chromadb.PersistentClient(path=db_path)
    collection = client.get_collection(collection_name)

    # 向量化查询
    query_embedding = model.encode(
        [query_text],
        normalize_embeddings=True
    ).tolist()

    # 检索[reference:9]
    results = collection.query(
        query_embeddings=query_embedding,
        n_results=n_results
    )

    # 打印结果
    print(f"\n查询: {query_text}")
    print("-" * 50)
    for i, (doc, dist) in enumerate(zip(results["documents"][0], results["distances"][0])):
        print(f"结果 {i+1} (相似度: {1 - dist:.4f}):")
        print(f"  {doc[:200]}...\n")

    return results


# ============ 5. 主程序 ============

if __name__ == "__main__":
    # 配置
    DOCUMENT_PATH = "./my_long_document.txt"  # 替换为你的文档路径
    DB_PATH = "./chroma_db"
    COLLECTION_NAME = "knowledge_base"

    # 第一步:向量化并存储(首次运行,耗时较长)
    embed_and_store(
        document_path=DOCUMENT_PATH,
        db_path=DB_PATH,
        collection_name=COLLECTION_NAME,
        chunk_size=512,      # token 数
        overlap=64,          # 重叠 token 数
        batch_size=100       # 每批处理 100 个块
    )

    # 第二步:查询测试
    query_knowledge(
        query_text="你的问题在这里",
        db_path=DB_PATH,
        collection_name=COLLECTION_NAME,
        n_results=5
    )